
AI 数据中心和比特币矿场有什么区别?
2026.10.22
本文从芯片、网络、供电、冷却和商业模式五个方面对比两类设施,解答“ASIC 矿机能否通过软件升级变成 AI 服务器”等常见问题,并分析矿场改造成 AI 数据中心的可行性。
AI 数据中心和比特币矿场都需要大规模的计算设备、电力供应和散热设施,但两者要解决的问题、使用的芯片和运维方式有本质差异。AI 数据中心主要用 GPU 等加速芯片完成大语言模型(LLM)训练、AI 推理和海量数据处理;比特币矿场则使用专门为 SHA-256 哈希算法设计的 ASIC 矿机,参与比特币网络的区块生产和账本安全维护。
本文从芯片、网络、供电、冷却和商业模式五个方面对比两类设施,解答“ASIC 矿机能否通过软件升级变成 AI 服务器”等常见问题,并分析矿场改造成 AI 数据中心的可行性。
AI 数据中心和比特币矿场分别是做什么的?
从最基本的用途来看,虽然 AI 数据中心和比特币矿场都在消耗数以兆瓦(MW)计的电力进行高速计算,但其计算的终极目的、产出的商业价值以及服务的最终用户完全不同。
AI 数据中心:为模型训练和推理提供计算能力
AI 数据中心专为人工智能模型的生命周期打造。它主要依靠由 GPU(图形处理器)或专用 AI 加速芯片构成的集群,处理高维度的矩阵乘法与复杂的并行计算。在日常使用场景中,AI 数据中心的算力输出通常分为两个阶段:
- 模型训练(Training): 类似于“让机器读书学习”。例如,一个涵盖千亿参数的大语言模型在上线前,需要数百或数千张 GPU 联合运行数周乃至数月,吞吐海量文本数据以学习语法、逻辑和知识。在此阶段,任何计算节点的数据丢失或中断都可能导致训练进度倒退。
- 模型推理(Inference): 类似于“用户向 AI 助手提问”。当你在 Chatbot 中输入一行提示词(Prompt)并秒级收到回答,或者上传照片生成艺术图像时,背后的 AI 展开的就是推理计算。推理阶段侧重于低延迟与高并发响应,直接面对企业或终端消费者。
比特币矿场:通过哈希计算参与网络共识
比特币矿场内部部署着成千上万台 ASIC 矿机不断尝试不同的随机数(Nonce),反复计算 SHA-256 哈希,寻找符合难度目标的结果。比特币网络大约每 10 分钟产生一个新区块,找到有效结果的一方获得记账权,并获得区块奖励和区块内的交易手续费。实际运营中,矿场通常加入矿池,由矿池统一出块后再按算力贡献分配收益。
比特币挖矿不处理用户的文本、图像或业务数据,它的算力只用于维护比特币账本的安全,让交易记录难以被篡改。
从外观上看,两类设施很容易被混淆:都有大型厂房或模块化集装箱、高压变配电设施、冷却塔或大型风机,以及 24 小时值守的运维团队。但外部基础设施相似,并不代表内部设备和运行方式可以互换。这就像货运机场和高铁站:两者都占地广、都需要高压供电和调度中心,但运行的交通工具和运输对象完全不同。
GPU vs. ASIC:两种计算设备有什么区别?
要理解 AI 数据中心与比特币矿场的区别,核心在于理解通用计算加速器(GPU)与专用集成电路(ASIC)的硬件设计差异。
| 维数 | GPU (如 NVIDIA H100/B200) | ASIC (如 比特币 ASIC 矿机) |
| 计算架构 | 通用并行计算:数千个核心,针对矩阵运算和浮点运算优化 | 固定功能电路:计算逻辑在芯片制造阶段已经固化,只支持 SHA-256 |
| 显存/内存 | 高带宽显存(HBM3/HBM3e):单卡带宽可达数 TB/s,满足大模型频繁读取参数的需要 | 只有极少量片上缓存,用于哈希计算的临时数据,没有独立显存 |
| 软件生态 | 成熟的开发生态(CUDA、PyTorch、TensorFlow),可以编程运行不同的 AI 框架 | 只有固件级控制:调节频率、监控温度、连接矿池 |
| 适用范围 | 广泛:LLM 训练、图像渲染、科学计算、自动驾驶仿真等 | 单一:只能用于 SHA-256 挖矿(比特币等),无法运行其他算法 |
GPU 最初为图形渲染设计,天生拥有成千上万个可以同时工作的计算核心。这种并行架构恰好契合深度学习中大量的矩阵乘法和加法运算。H100、B200 这类高端 AI 芯片还配备了昂贵的高带宽显存(HBM),因为大语言模型的参数动辄数百亿、上千亿,GPU 必须在极短时间内把海量数据在显存和计算核心之间来回搬运。加上成熟的 CUDA 软件生态,开发者只要修改代码,就能让同一组 GPU 今天训练语言模型,明天处理图像生成或自动驾驶仿真。
ASIC 是为某一特定用途专门设计的芯片。比特币矿机芯片在设计时,就把 SHA-256 的计算逻辑直接做进了电路里。由于去掉了显示输出、复杂指令集、通用内存控制器等与哈希计算无关的功能,ASIC 能把几乎全部的芯片面积和功耗都用于哈希计算,因此在执行 SHA-256 时,能效和计算密度远超任何 CPU 或 GPU。代价是,它完全失去了通用性。
为什么 ASIC 矿机不能通过升级软件变成 AI 服务器?
这是初学者常见的误区。答案很明确:无论怎样升级固件或软件,ASIC 矿机都无法变成 AI 服务器,因为这种局限来自芯片的物理电路。打个比方:GPU 像一台高性能电脑,装上不同的软件,就能写文章、做设计、玩游戏、跑科学计算;ASIC 则像流水线上专门压制瓶盖的冲床,它的机械结构就是为这一个动作打造的,给工人换再好的操作手册(升级软件),冲床也不能用来打字或画图。
矿机的控制板虽然运行着简化的嵌入式系统,但它只负责管理设备和连接矿池,算力很弱。真正的计算芯片只能执行 SHA-256,没有深度学习所需的矩阵运算单元,也没有高带宽显存。
计算任务不同,为什么会影响网络和可靠性要求?
大型 AI 模型训练时,单张 GPU 的显存装不下整个模型,必须把任务拆分到多张卡、多台服务器上并行计算。成百上千张 GPU 每完成一步计算,都要相互交换数据、同步参数。只要有一条网络链路拥堵或延迟升高,整个集群都得停下来等它,算力利用率会大幅下降。因此,AI 数据中心除了普通以太网,还要部署 NVLink 等节点间高速互联,以及超高带宽、低丢包的 RDMA 网络(如 InfiniBand 或 RoCE v2)。
比特币矿机则完全不同。如果说 AI 集群是“团队协作”,矿机就是“各自独立作业”:矿场里几万台矿机彼此之间不需要交换任何数据。每台矿机只需从矿池接收很小的任务数据(通常不超过几 KB),在本地独立计算,再持续把达到矿池难度的结果(份额)提交回去。整个过程数据量很小,所以矿场不需要昂贵的高速内部网络,稳定的商业宽带通常就够用。
为什么 AI 数据中心更重视不间断运行?
计算任务的属性同样决定了设施对供电中断的容忍度:
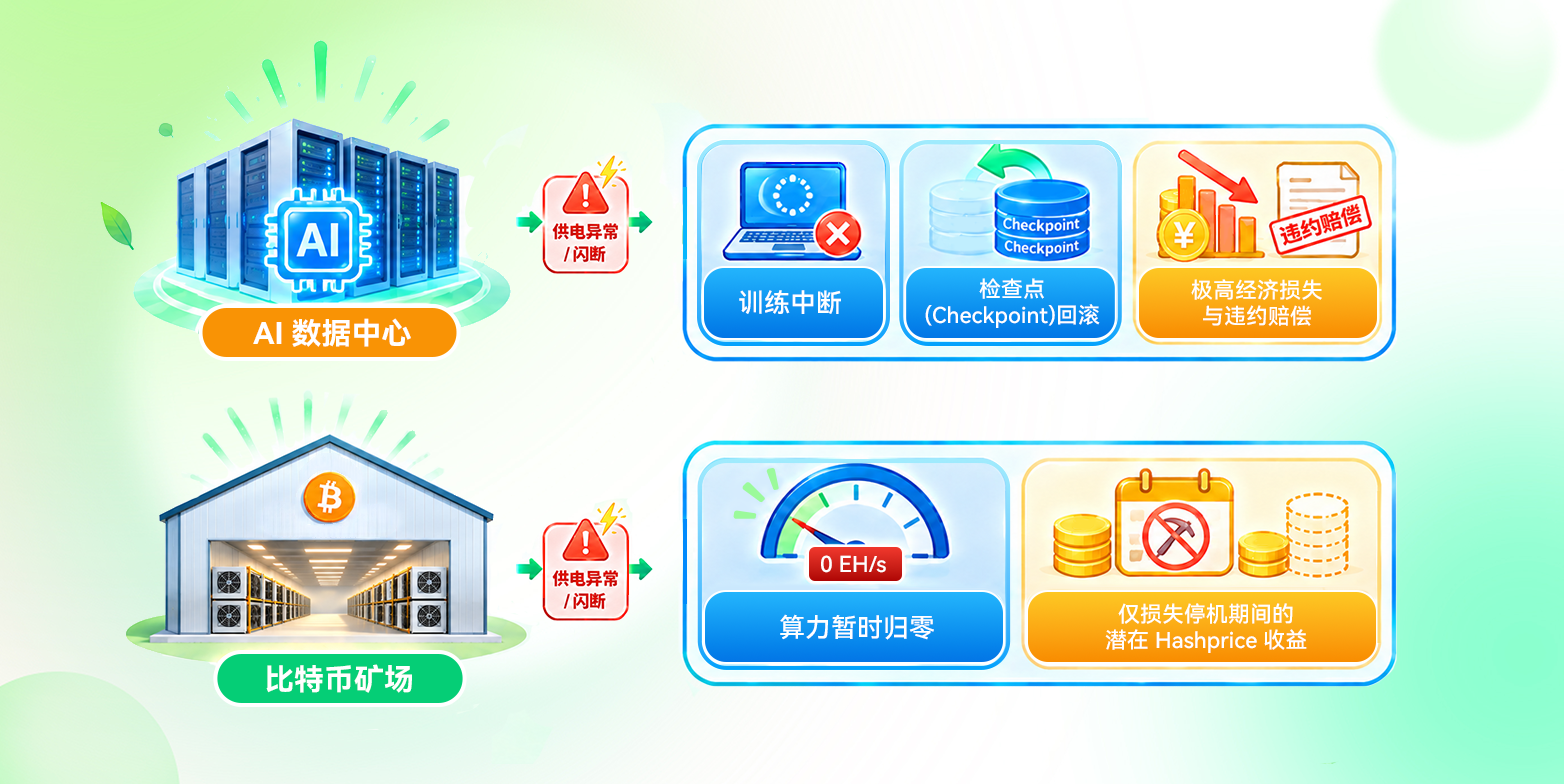
企业级 AI 推理服务一旦中断,会导致客户业务瘫痪并触发高额的服务等级协议(SLA)违约赔偿;而在万卡级别的训练大模型过程中,突然断电可能导致内存中尚未保存的计算状态丢失,引发检查点(Checkpoint)回滚与数小时甚至数天的算力浪费。因此,AI 数据中心通常需要严格配置 2N 或 N+1 的不间断电源(UPS)及柴油发电机组。
比特币挖矿每秒都在进行独立的哈希尝试,不存在“计算进度累积”的概念。矿场可以在电价飙升或电网负荷高峰时快速降低负荷甚至停机,这让比特币矿场天然具备很强的电网调节灵活性。不过,频繁断电重启也会增加电源和算力板的损耗。
冷却方式和功率密度有什么区别?
散热是数据中心工程中最大的物理挑战之一。两类设施都要处理兆瓦级的发热,但由于机柜功率密度不同,冷却方案的设计思路也明显不同。
传统通用 IT 机柜的功率密度通常在 5–10 kW;而旗舰 AI 芯片单颗功耗已达 700–1,000 W 以上,最新的高密度 GPU 机柜(如 NVIDIA NVL72 架构)单柜功耗可超过 100 kW。在这样的密度下,空气已经来不及带走芯片表面的热量。
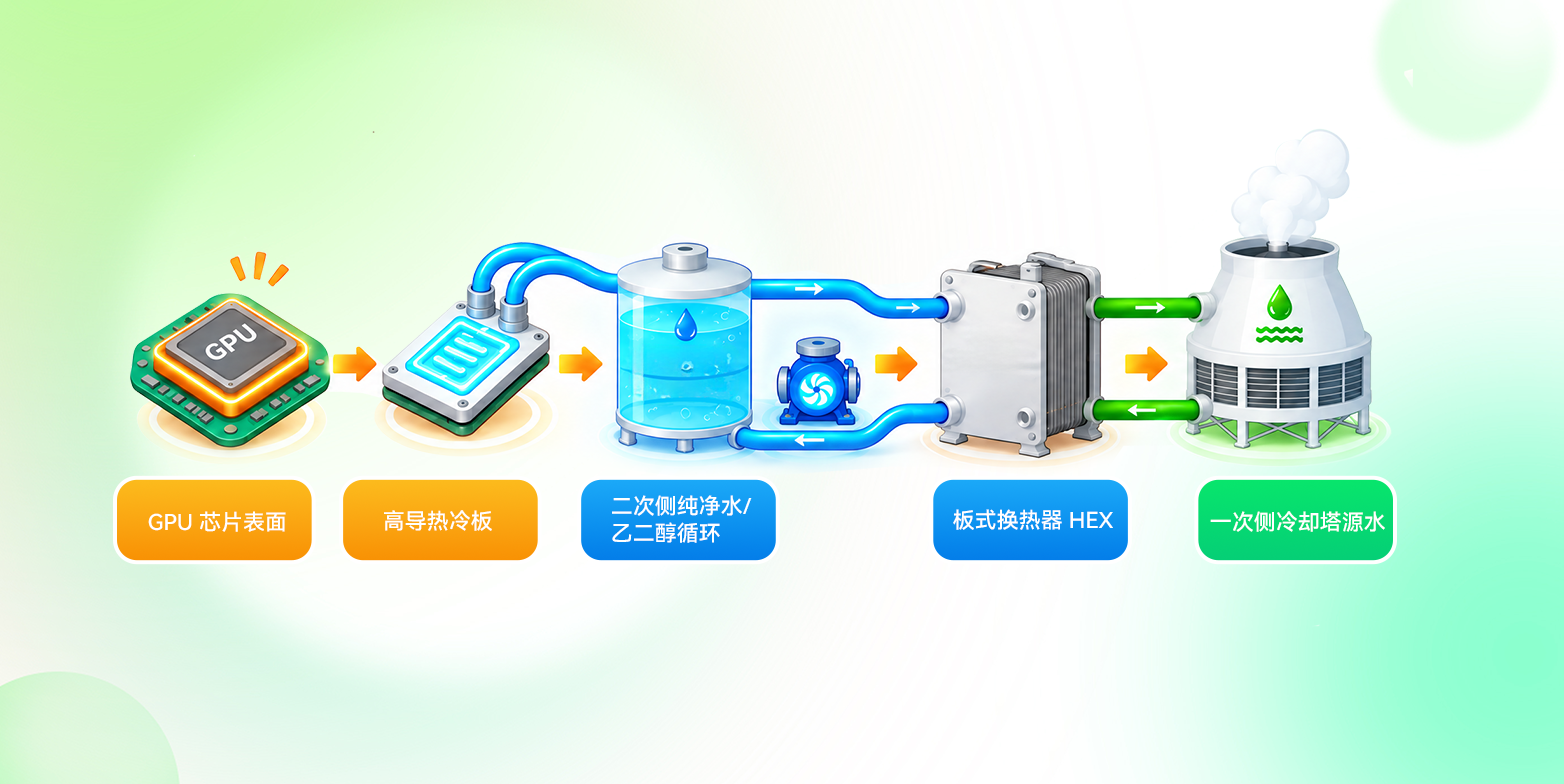
因此,AI 数据中心正加速转向冷板式直接液冷。高纯度冷却液流经紧贴在 GPU 芯片表面的金属冷板,把热量带到冷却液分配单元(CDU)中的换热器,再通过一次侧的冷却水系统(如冷却塔)排到室外。
比特币矿场通常采用哪些冷却方式?
比特币矿场由于设备专用且成本敏感,冷却方案的选择更加多样化,主要取决于当地的气候条件、电价和成本考量。传统矿场普遍采用大风量工业风机配合水帘降温的负压风冷厂房。其优点是初始建设成本极低,但在高温、高湿或多沙尘地区维护成本较高。
随着高密度矿机(例如以 SEALMINER 为代表的专用水冷矿机)的普及,采用闭式冷却塔结合水冷集装箱的方案应用日益广泛。水冷集装箱大幅提升了单箱部署密度、降低了风扇运行噪音,并在高温环境下展现出极佳的能效表现。
还有一种把矿机完全浸泡在绝缘冷却液中,由液体直接带走算力板的热量的方案叫做油冷(浸没式冷却)。这种方案支持更高的超频性能,也能防尘,但冷却液和维护成本较高。
即使同样拥有 20 MW 的电力容量,AI 数据中心可能需要部署上百个高密度液冷机柜,并配套高规格的温控系统;比特币矿场则可能直接部署几十个模块化水冷集装箱,或建一座长条形的负压风冷厂房。两者在建筑结构、管道布置和流体工程上差别很大。
AI 数据中心和比特币矿场的成本与收入模式有什么不同?
从商业视角来看,AI 数据中心与比特币矿场代表了两种截然不同的资产运营与收益变现逻辑。即使在消耗相同电力(如 1 MW)的物理前提下,两者的收入来源、成本结构及市场风险敞口也完全不同。
AI 数据中心如何赚钱?
AI 数据中心的商业模式更接近传统的 B2B 科技基础设施服务,其收入核心建立在客户合同与服务质量(SLA)之上:
- GPU 算力租赁: 按小时、按月或按年向 AI 创业公司、大模型研发机构或企业客户出租 GPU 算力节点(如 H100/B200 集群)。客户根据使用的算力时长和机房流量付费。
- 托管服务(Colocation): 客户自行采购 GPU 服务器,数据中心仅出让机柜空间、高冗余电力、高规格液冷以及网络带宽,按兆瓦(MW)或机柜月租收取服务费。
- 行业解决方案: 为金融、医疗、自动驾驶等特定行业提供经过优化的专用推理或微调算力平台。
这类收入的稳定性取决于客户订单量、GPU 利用率和续约率。拿到长期企业合同后,现金流通常比较稳定;但如果竞争加剧、GPU 闲置,数据中心仍要承担高昂的设备折旧和场地成本。
比特币矿场如何赚钱?
比特币矿场的商业模式则非常直接,其本质是将物理电力转化为加密代币的单向生产过程:矿场内部的 ASIC 矿机接入比特币网络,通过贡献哈希算力参与竞争记账。矿池成功出块后,获得区块奖励和交易手续费,再按各矿场贡献的有效算力,按约定的结算方式(如 FPPS、PPLNS)分配收益。挖到的比特币可以在市场上随时变现,也可以作为资产持有。
挖矿收入具备明显的波动性与周期性。每天的美元收入取决于比特币价格、全网难度和本地电价,这三者共同决定了算力收益(Hashprice)和利润空间。和 AI 数据中心不同,矿场不需要销售团队找客户,只要矿机开机并连接矿池,矿池就会按结算周期自动结算收益。
比特币矿场可以改造成 AI 数据中心吗?
随着 AI 算力需求爆发,许多拥有兆瓦级电力和土地资源的矿场开始考虑:既然都耗电,能不能把矿场改造成 AI 数据中心?答案是:场地基础设施有一定的再利用价值,但改造远不是“拔掉 ASIC、换上 GPU”那么简单。
比特小鹿(Bitdeer)还正在将其位于挪威的 Tydal 比特币矿场转型为人工智能/高性能计算(AI/HPC)数据中心基础设施。2026 年 11 月 10 日发布的 2026 年第三季度财报显示,项目正分阶段推进,预计第一阶段将于 2026 年第四季度投入运营。
哪些基础设施有机会继续利用?
在场地整体改造的工程中,上游重资产基础设施通常具备较高的保留与二次利用价值。已经拿到的工业用地使用权、大容量高压专线以及变电站接入配额是 AI 数据中心建设中最难获取的稀缺资源。
厂区上游的高压主变压器、部分开关柜及一次侧配电线路,在经过电气合规检测后也可以继续保留使用。园区现有的冷却塔一次侧供水管网、外围物理安防围栏、厂区道路及基础土建,像这些基础建设也能够节省一部分前期建造成本。(相关拓展阅读:旧 AI 显卡还能赚钱吗?看懂算力硬件的二次利用)
为什么不能直接把 ASIC 换成 GPU 就开始运营?
土地和电力可以保留,但机房内部和核心 IT 基础设施需要大规模改造。
| 改造项目 | 传统比特币矿场 | AI 数据中心的要求 |
| 供电冗余 | 多为单路供电(N 架构),可以接受短时断电 | 需要补齐 UPS 和柴油发电机,达到 2N 或 N+1 冗余 |
| 网络 | 几条商业宽带 | 高性能交换机和低延迟内部互联(InfiniBand 或 RoCE v2),以及高带宽光纤接入 |
| 冷却 | 大风量风冷或水冷集装箱 | 精密温控的冷板液冷,二次侧系统需要重新设计 |
| 机房环境与合规 | 简易工业厂房,基本防尘即可 | 严格控制粉尘、温湿度(防静电和冷凝),具备物理安防,并通过 SOC 2 等合规审计 |
其中供电和网络的改造投入最大,按每 MW 计算,改造成本通常远高于矿场原有的建设成本。(相关拓展阅读:AI 数据中心和比特币挖矿能共用同一个数据中心吗?)
矿场转型 AI 数据中心值得吗?
并非所有矿场都适合转型。AI 训练主要要求集群内部的低延迟互联,对站点与用户之间的距离不太敏感,因此电价低、电力充足的偏远站点也有机会承接训练业务;但实时推理服务需要靠近用户和主要网络节点,远离城市的站点在这方面并不占优势。此外,站点还需要具备高带宽光纤接入,才能满足数据传输需求。对于网络条件有限、但电价很有竞争力的站点,继续专注比特币挖矿,或者采用上游共用电力、下游分区运行的混合模式(Hybrid Site),往往比承担高昂的改造成本更合理。(相关拓展阅读:比特币数据中心如何转型 HPC 时代?)
常见误区:关于 AI 数据中心和比特币矿场的四个误解
误区一:ASIC 矿机升级软件后就能运行 AI 模型
正如前文所述,ASIC 的计算逻辑在芯片制造(流片)阶段就已固化为 SHA-256 电路,缺少深度学习所需的矩阵运算单元和高带宽显存。
误区二:AI 数据中心一定比比特币矿场更耗电
设施的总耗电量取决于设备规模和功率密度,而不是业务类型。一座部署 10 万台矿机的大型矿场,总功耗可达 300 MW 以上;而一座中等规模的 AI 推理数据中心,总功耗可能只有 20 MW 左右。
误区三:液冷矿场可以直接变成液冷 AI 数据中心
两者都用液体散热,但冷却架构差别很大。水冷矿机通常能在较高的进水温度下运行,对冗余和温控精度的要求也相对较低;GPU 液冷则对冷却液纯度、流量稳定性、过滤和温控精度有更严格的要求,还需要配置专用的冷却液分配单元(CDU)。因此,水冷矿场的冷却塔和一次侧管网可以部分复用,但二次侧系统通常需要重新设计。
误区四:AI 的收益一定比比特币挖矿稳定
两者的风险结构不同。AI 数据中心有机会签下长期合同,但也面临客户集中、GPU 更新换代快导致设备贬值,以及没有订单时仍要承担高额折旧的压力。挖矿收入每天随币价和难度波动,当算力收益跌破电费成本时,矿机也会被迫关机;但挖出的比特币可以随时在市场上变现,不存在“找不到客户”的问题。
AI 数据中心和比特币矿场的本质区别是什么?
一句话概括:AI 数据中心是为复杂计算服务打造的精密设施,追求通用性、低延迟、高供电冗余和企业级服务质量;比特币矿场是把电力高效转化为比特币的工业设施,追求低电价、高能效和灵活的负荷调节。理解这些差异,有助于基础设施开发者和投资者在规划新项目、改造旧站点或做算力投资时作出更合理的判断。想了解更多算力基础设施和 AI 云服务,欢迎访问比特小鹿(Bitdeer)学习中心,或了解比特小鹿(Bitdeer)AI Cloud。
*本文提供的資訊僅供一般參考,並不構成也不應被理解為任何產品的廣告、專業意見、要約、招攬或建議,也不涉及任何產品的交易。對於任何資訊的公正性、準確性、及時性、完整性或正確性,以及任何產品的未來回報、表現或結果,比特小鹿(Bitdeer)不作出任何明示或暗示的保證、陳述、擔保或承諾。在適用法律允許的範圍內,比特小鹿(Bitdeer)明確排除與本文提供的資訊有關的任何和所有責任,並且在任何情況下,比特小鹿(Bitdeer)都不對任何人因依賴本文的任何資訊而產生的任何損失或遭受的損害負責。


